AI 伺服器機櫃 2026:Vera Rubin NVL72 與 AMD Helios,為何以整個機櫃部署?
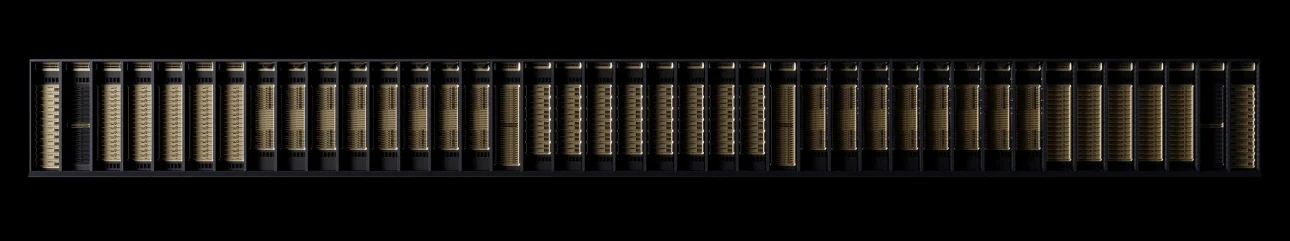
AI 伺服器的部署單位,正由單台 8-GPU 伺服器擴展至整個機櫃。機櫃功率由 Hopper 年代約 30 至 40 kW,升至 Vera Rubin NVL72 約 190 至 230 kW,並向 2027 年約 600 kW 的 Kyber 機櫃推進。互連、供電、液冷與維運因此必須以機櫃為單位設計。本文整理 HGX、MGX 與機櫃級平台的分工,NVIDIA 與 AMD 兩條機櫃路線,以及 Dell、HPE、Supermicro、Lenovo 等 OEM 平台在 2026 年的進展。
重點摘要
- 機櫃功率:業界分析估算 GB200/GB300 NVL72 約 120 至 140 kW,Vera Rubin NVL72 約 190 至 230 kW;NVIDIA 於 GTC 2025 表示 2027 年的 Kyber 機櫃約 600 kW。
- 液冷:Vera Rubin NVL72 採用 45°C 入水溫度的全液冷設計,運算托盤無風扇,可減少或免除冷水機。
- 供電:機櫃供電由 54V 直流匯流排走向 800 VDC,NVIDIA 已在 OCP 公布 800 VDC 機櫃路線,Vertiv 亦推出 800 VDC MGX 參考架構。
- 開放路線:AMD Helios 採用 Meta 的 Open Rack Wide 雙寬機櫃,以 UALink over Ethernet 作機櫃內 scale-up 互連,以 Ultra Ethernet 作 scale-out。
- OEM 進度:Dell 於 2026 年 6 月首家交付 Vera Rubin NVL72 機櫃,Supermicro 於 9 月開始出貨,HPE 的 Vera Rubin NVL72 預計 12 月推出,並已取得首宗 Helios 部署訂單。
平台形態總覽
| 形態 | 代表平台 | 高速互連範圍 | 散熱 | 部署單位 |
|---|---|---|---|---|
| 8-GPU 伺服器(HGX) | HGX B300、HGX Rubin NVL8 | 8 GPU | 風冷或液冷 | 單台伺服器 |
| 模組化伺服器(MGX) | NVIDIA MGX 參考架構 | 按配置 | 風冷或液冷 | 單台伺服器 |
| NVL72 機櫃(Oberon) | GB200 NVL72、GB300 NVL72 | 72 GPU | 液冷 | 整個機櫃 |
| NVL72 機櫃(第三代 MGX) | Vera Rubin NVL72 | 72 GPU | 全液冷,45°C 入水 | 整個機櫃 |
| Kyber 機櫃 | Rubin Ultra(2027 年) | NVL144 至 NVL576 | 全液冷,800 VDC 供電 | 整個機櫃 |
| Open Rack Wide 雙寬機櫃 | AMD Helios | 72 GPU | 液冷,背面快速接頭 | 整個機櫃 |
當同步開始決定一項工作的速度
模型超出單機資源後,每增加一台伺服器,也增加了一條通訊邊界;擴展效益取決於新增算力能否抵過同步等待。
大型模型的訓練與推理,需要 GPU 之間反覆交換數據、等待同步,再繼續下一段運算。如果新增的運算能力抵不過通訊等待,擴展便不會按台數線性增長。Rack-scale 的意義,在於把高速互連的範圍由一台伺服器擴大到整個機櫃,讓更多 GPU 在同一個低延遲域內協同運作。
8-GPU 伺服器仍然是實用的設計單位,適合中等規模的訓練、微調與推理。機櫃級平台的不同之處,是把互連、電力、冷卻與維運的協同範圍一併往外推,而不是單純在機櫃裏多放幾台機器。
HGX、MGX 與機櫃級:三個不同的抽象層
HGX、MGX 與 NVL72 回答的是不同層次的問題,不是互相排斥的產品選項。
- HGX:8-GPU 加速基板,回答多 GPU 平台如何組成。OEM 以此製造伺服器,例如 Dell PowerEdge XE9780 為 10U 風冷版本,XE9780L 為液冷版本,兩者均可搭載 HGX B300。
- MGX:NVIDIA 的模組化伺服器與機櫃參考架構,讓 OEM 以標準化的機構、供電與散熱模組,組合出不同的 CPU、GPU 與 DPU 配置。Vera Rubin NVL72 即採用第三代 MGX 機櫃架構。
- 機櫃級系統:整個機櫃作為一個產品交付與驗收。NVIDIA 表示,GB300 NVL72 所用的 MGX 機櫃尺寸,亦用於 Vera Rubin NVL72 與 Vera Rubin CPX 等平台,讓數據中心可以沿用同一套機櫃設計。
相同的平台名稱,不代表相同的儲存、網絡或散熱設計。採購單台系統時,可以逐台核對這些差異;部署機櫃級系統時,它們還牽涉共同的支援範圍與維修單位。
機櫃功率:由 40 kW 級到 600 kW
每一代機櫃功率都大幅上升,數據中心的電力與散熱容量,已成為部署 AI 機櫃的首要條件。
| 世代 | 年份 | 每機櫃功率(業界分析估算) |
|---|---|---|
| Hopper(8-GPU 伺服器組成的機櫃) | 2023 至 2024 年 | 約 30 至 40 kW |
| GB200/GB300 NVL72 | 2024 至 2025 年 | 約 120 至 140 kW |
| Vera Rubin NVL72 | 2026 年 | 約 190 至 230 kW |
| Rubin Ultra Kyber | 2027 年 | 約 600 kW |
傳統企業機櫃一般只有 5 至 15 kW,即使積極優化氣流,風冷機櫃大約也只能做到 40 kW。NVIDIA 為 Vera Rubin NVL72 加入動態機櫃功率調度與「Intelligent Power Smoothing」,配合機櫃內的儲能平滑負載波動;NVIDIA 表示,其 DSX MaxLPS 可讓營運商在相同電力預算內多部署最多 40% 的 GPU。
供電:由 54V 匯流排到 800 VDC
機櫃功率上升,令傳統交流配電與低壓匯流排面臨銅材用量與損耗的限制,供電架構正轉向 800 VDC 直流。
現行 NVL72 機櫃多採用機櫃級電源架。以 Dell PowerEdge XE9712(GB300 NVL72)為例,48U 的 IR9048 機櫃採用 OCP Open Rack v3 設計,以 33 kW 電源架將交流電轉為 54V 直流,經機櫃匯流排供電,省去傳統 PDU。
NVIDIA 的下一步是 800 VDC:由設施端直接以 800V 直流配電到機櫃。與 415/480V 三相交流相比,同樣的銅導體可傳輸超過 150% 的額外電力。NVIDIA 在 Hot Chips 2026 介紹的 Vera Rubin NVL72 機櫃,已採用 800 VDC、液冷匯流排、免重定時器的銅纜 scale-up 互連,以及可熱插拔的無纜線托盤;2027 年的 Kyber 機櫃則全面以 800 VDC 為基礎。Vertiv 已推出 800 VDC MGX 參考架構,HPE 亦宣布支援 Kyber。
液冷:45°C 溫水與 CDU
液冷已由選配變為機櫃級平台的前提;入水溫度提高,則讓數據中心可以減少甚至免除冷水機。
Vera Rubin NVL72 採用全液冷設計,運算托盤沒有風扇,冷卻液入水溫度為 45°C。較高的入水溫度擴大了冷卻迴路與室外環境的溫差,很多地區因此可以只靠冷卻塔散熱,把更多電力預算留給運算。
液冷系統由晶片延伸到設施:冷板、歧管、軟管、機櫃電源架、冷卻液分配單元(CDU)、後門熱交換器,以及設施端冷卻塔。CDU 分為列間式、機櫃內式與液對氣側櫃等形式。Supermicro 的 DLC-2 方案即涵蓋由冷板到冷卻塔的整條迴路,CDU 容量達 1.8 MW;Lenovo 則把 Neptune 液冷技術延伸至 Rubin 平台。
部署前需要確認設施的供回水溫度與流量、熱交換能力、漏液監控,以及維護責任的分界。
Scale-up 與 scale-out:NVLink、UALink 與 Ethernet
機櫃內的 scale-up 互連與機櫃之間的 scale-out 網絡,是兩個不同的設計問題,各自有專屬與開放兩條路線。
| 層級 | NVIDIA 路線 | 開放標準路線 |
|---|---|---|
| Scale-up(機櫃內 GPU 互連) | NVLink 與 NVLink Switch | UALink;UALink over Ethernet(UALoE) |
| Scale-out(機櫃之間) | InfiniBand、Spectrum-X Ethernet | Ultra Ethernet(UEC)、RoCE |
UALink 聯盟於 2025 年 4 月發佈 UALink 1.0 規範,以每通道 200G 連接最多 1,024 個加速器;Ultra Ethernet 聯盟於 2025 年 6 月發佈 1.0 規範,針對 AI 與 HPC 的大規模以太網傳輸。
連線的標稱速率只是起點。軟件的通訊模式、壅塞控制與網絡拓撲,都會影響有效傳輸。應用測試需要觀察同步等待時間與故障後的恢復,而不只看連線規格。各款 GPU 平台的互連頻寬,詳見 企業 AI GPU 2026。
AMD Helios:開放機櫃路線
AMD Helios 以開放標準組成機櫃級系統,是 NVIDIA MGX 機櫃之外的另一條路線。
- 機構:採用 Meta 提交 OCP 的 Open Rack Wide(ORW)雙寬機櫃規格,配合背面快速接頭液冷,以改善維修便利性。
- 組成:每個機櫃有 72 個 AMD Instinct MI455X GPU,配搭第六代 EPYC「Venice」CPU、Pensando Vulcano AI 網卡與 Salina DPU。
- Scale-up:以 UALink over Ethernet 連接 72 個 GPU,AMD 公布的總頻寬為 260 TB/s。
- Scale-out:每個 GPU 配三張 800G Vulcano 網卡,即每 GPU 2.4 Tb/s,支援 Ultra Ethernet 傳輸;全櫃 scale-out 頻寬為 43 TB/s。
HPE 為 Helios 推出 Juniper Networking QFX5252 scale-up 以太網交換器,採用 Broadcom Tomahawk 6 晶片,每個機櫃配置六個交換器托盤,並已於 2026 年 9 月取得首宗 Helios 部署訂單。OpenAI、Meta、Oracle、Microsoft 與 Anthropic 等均已宣布採用 Helios。
OEM 與 ODM 機櫃平台
| 廠商 | 平台 | 架構 | 2026 年進度 |
|---|---|---|---|
| Dell | PowerEdge XE9712 | GB300 NVL72,48U ORv3 機櫃 | 已出貨 |
| Dell | PowerEdge XE9812 | Vera Rubin NVL72 | 已出貨 2026 年 6 月首批交付 CoreWeave |
| Dell | PowerEdge XE8812 | Vera Rubin NVL4,每機櫃 144 個 GPU,面向 HPC | 已發佈 預計 2027 年初 |
| Dell | PowerEdge XE9780/XE9780L | HGX B300 8-GPU,風冷/液冷 | 已出貨 |
| Supermicro | Vera Rubin NVL72 機櫃 | Vera Rubin NVL72,DLC-2 液冷 | 已出貨 2026 年 9 月起 |
| HPE | Vera Rubin NVL72 by HPE | Vera Rubin NVL72 | 已發佈 預計 2026 年 12 月 |
| HPE | AMD Helios AI Rack by HPE | AMD Helios,UALoE scale-up | 已發佈 首宗部署訂單 |
| Lenovo | Neptune 液冷 Rubin 平台 | Vera Rubin | 已發佈 |
機櫃級系統的整機製造,主要由台灣 ODM 承擔,包括鴻海(Foxconn)、廣達(Quanta)與緯創(Wistron)。OEM 的差異主要在於液冷與設施設備的整合範圍、工廠預先整合與測試的程度、部署服務,以及管理軟件。
維運與故障範圍
機櫃越整合,一個共同部件停機影響的工作範圍就越大;冗餘設計應與服務目標一致。
更換運算托盤、交換器托盤或電源架時,需要預先確定停機範圍:哪個部件停下來,會影響哪一組工作。供電、網絡與冷卻的冗餘,應與服務目標一致,避免一個共同部件成為整個協同範圍的單點限制。
驗證時,以數據進入、CPU 預處理、GPU 執行、跨節點同步到檢查點寫入,作完整路徑測試。先確保一條路徑穩定,再擴大並發與節點數。這種方法能把機櫃設計轉化為可量度的服務能力,而不只是更大的硬件清單。
評估框架
| 評估維度 | 關注指標 |
|---|---|
| 設施電力 | 每機櫃功率上限、配電方式(交流或 800 VDC)、冗餘等級 |
| 散熱 | 入水溫度與流量、CDU 容量、是否需要冷水機、漏液監控 |
| 結構 | 機櫃重量與樓板承重、機櫃尺寸(標準或雙寬) |
| 互連 | Scale-up 範圍、scale-out 拓撲與壅塞控制、同步等待時間 |
| 服務表現 | 每兆瓦可產出的 token 數、首 token 延遲、故障後恢復時間 |
| 維運 | 托盤熱插拔、停機範圍、維護責任分界、部署所需時間 |
常見問題
- HGX 與 MGX 有甚麼分別?
- HGX 是 8-GPU 加速基板,回答多 GPU 平台如何組成;MGX 是模組化的伺服器與機櫃參考架構,讓 OEM 以標準模組組合不同配置。Vera Rubin NVL72 即採用第三代 MGX 機櫃架構。
- 一個 Vera Rubin NVL72 機櫃需要多少電力?
- 業界分析估算約 190 至 230 kW,高於 GB200/GB300 NVL72 的約 120 至 140 kW。NVIDIA 於 GTC 2025 表示,2027 年的 Kyber 機櫃約 600 kW。
- 為甚麼 AI 機櫃需要液冷?
- 風冷機櫃大約只能處理 40 kW,而 NVL72 機櫃已超過 120 kW。Vera Rubin NVL72 採用 45°C 入水的全液冷設計,運算托盤無風扇,並可減少或免除冷水機。
- AMD Helios 與 NVIDIA NVL72 有何不同?
- 兩者都以 72 個 GPU 為一個機櫃。Helios 採用 Open Rack Wide 雙寬機櫃,以 UALink over Ethernet 作 scale-up、Ultra Ethernet 作 scale-out;NVIDIA NVL72 採用 MGX 機櫃,以 NVLink 作 scale-up、InfiniBand 或 Spectrum-X 作 scale-out。
延伸閱讀
- 企業 AI GPU 2026:H200、Blackwell 到 Vera Rubin,GPU 越多為何未必越快?
- PCIe Gen6 企業 SSD 2026:Micron 9650 與 Samsung PM1763,速度翻倍能否減少 GPU 等待?
- 企業伺服器平衡設計 2026:CPU、GPU、記憶體與 NVMe 都升級了,為何沒變快?
資料來源
- NVIDIA Technical Blog:Vera Rubin NVL72 機櫃設計
- NVIDIA:OCP、800 VDC 與 Kyber
- ServeTheHome:Vera Rubin NVL72 機櫃(Hot Chips 2026)
- SemiAnalysis:Vera Rubin 機櫃供電與液冷
- ModuleEdge:機櫃功率路線與 800 VDC
- NVIDIA Vera Rubin NVL72
- NVIDIA MGX
- Dell PowerEdge XE9712 規格表
- Dell:首批 Vera Rubin NVL72 機櫃交付
- iTWire:Dell XE8812、HPE 與 Lenovo Rubin 平台
- Supermicro Vera Rubin NVL72 出貨與 DLC-2
- AMD 與 HPE:Helios 開放機櫃
- Fierce Network:Helios 的 UALoE 與 Ultra Ethernet
- Converge Digest:Helios 與 Open Rack Wide
- HPE:首宗 Helios 部署與 QFX5252 交換器
- Silicon Report:Vera Rubin ODM 與出貨時程
- UALink Consortium 技術資料
資料更新日期:2026-10-01